La inteligencia artificial está avanzando a una velocidad que hace pocos años parecía imposible. Hoy podemos utilizar modelos capaces de escribir textos, programar, analizar documentos, generar imágenes, automatizar tareas y operar herramientas digitales.
Pero junto con sus beneficios han aparecido preguntas cada vez más importantes: ¿cuáles son los riesgos reales de la inteligencia artificial?, ¿puede provocar una catástrofe?, ¿qué relación existe entre la competencia de China y Estados Unidos?, ¿son seguras las IA gratuitas?, ¿conviene utilizar DeepSeek o Qwen?, ¿y cómo podemos aprovechar la IA sin perder nuestra privacidad y seguridad?
La respuesta no es que toda inteligencia artificial sea peligrosa ni que una catástrofe sea inevitable.
El problema es más complejo.
Algunos riesgos ya están ocurriendo. Otros son posibles y requieren investigación. Y otros escenarios extremadamente dramáticos que circulan por redes sociales todavía pertenecen al terreno de la especulación.
Por eso es importante separar los riesgos comprobables de las exageraciones, así como entender la diferencia fundamental entre utilizar servicios cerrados en la nube y ejecutar modelos de pesos abiertos (open-weights) bajo nuestro propio control.
¿La inteligencia artificial realmente representa un peligro?
Sí, pero no todos los peligros son iguales.
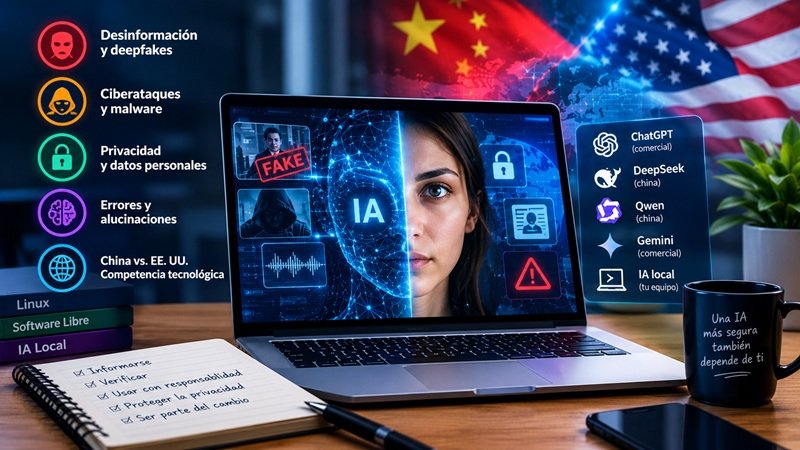
El riesgo más inmediato no necesariamente es una superinteligencia que escape de control. Actualmente existen problemas mucho más concretos: fraude, suplantación de identidad, desinformación, generación de malware, ataques automatizados, filtración de información confidencial, errores en decisiones importantes y dependencia excesiva de sistemas que pueden equivocarse.
El propio Instituto Nacional de Estándares y Tecnología de Estados Unidos (NIST) mantiene el AI Risk Management Framework (AI RMF), un marco para gestionar los riesgos asociados con los sistemas de inteligencia artificial. NIST también publicó un perfil específico para la IA generativa y, en abril de 2026, comenzó el desarrollo de un perfil orientado a una inteligencia artificial confiable para infraestructura crítica.
Esto demuestra algo importante: los riesgos de la IA no son solamente una preocupación de usuarios de redes sociales; también son objeto de investigación técnica y de gestión institucional.
Los principales riesgos reales de la inteligencia artificial
1. Desinformación y contenido falso
Una de las amenazas más visibles es la capacidad de producir grandes cantidades de contenido convincente.
Una persona puede utilizar IA para generar:
- noticias falsas;
- imágenes manipuladas;
- voces artificiales;
- vídeos falsificados;
- perfiles falsos;
- comentarios automatizados;
- campañas de spam;
- textos aparentemente escritos por personas reales.
El problema aumenta cuando una persona ya no puede distinguir fácilmente entre contenido auténtico y contenido generado artificialmente.
Los llamados deepfakes pueden utilizarse para suplantar a una persona, manipular declaraciones o intentar engañar a familiares, clientes o trabajadores.
Por eso una regla fundamental para el uso de IA es:
Que una imagen, vídeo, audio o texto parezca real no significa que sea verdadero.
La verificación de fuentes será cada vez más importante.
2. Ciberataques más rápidos y automatizados
La IA también puede utilizarse para mejorar determinadas actividades ofensivas en ciberseguridad.
Los modelos ayudan a analizar código, identificar vulnerabilidades y automatizar fases de un ataque. Además, con la llegada de los agentes autónomos, surge un riesgo crítico: la inyección indirecta de comandos (Indirect Prompt Injection), donde un atacante oculta instrucciones maliciosas en un sitio web o documento para que la IA las ejecute sin que el usuario lo note.
Esto tiene una doble cara. La misma tecnología ayuda a los defensores a detectar brechas, analizar grandes volúmenes de registros y responder a incidentes en tiempo real. Pero también proporciona herramientas avanzadas a los atacantes.
En septiembre de 2026, OpenAI informó que GPT-6 Astra había alcanzado el Umbral crítico de capacidad en ciberseguridad establecido en su Marco de preparación. Según las evaluaciones de la empresa, Astra puede, con las herramientas y los accesos adecuados, identificar vulnerabilidades de seguridad previamente desconocidas y desarrollar formas de explotarlas. Al mismo tiempo, OpenAI implementó salvaguardas adicionales y limitó determinadas capacidades ofensivas en la versión desplegada, mientras continúa evaluando sus riesgos de uso indebido.
Por eso el problema no consiste simplemente en preguntar si una IA «es buena o mala».
La pregunta correcta es:
¿Qué capacidades tiene, quién puede utilizarlas, con qué herramientas y qué controles existen?
3. Errores y alucinaciones
Los modelos de lenguaje pueden producir respuestas convincentes que contienen información falsa.
Esto es especialmente peligroso cuando el usuario confía en la respuesta sin comprobarla.
Una IA puede:
- inventar una fuente;
- atribuir una cita a una persona equivocada;
- proporcionar un comando incorrecto;
- interpretar mal un documento;
- cometer errores matemáticos;
- inventar datos;
- entregar código vulnerable.
Por eso una IA no debe convertirse automáticamente en una autoridad.
Cuanto más importante sea la decisión, mayor debe ser la verificación humana.
No es lo mismo utilizar una IA para generar ideas para un artículo que utilizarla para tomar una decisión médica, jurídica, financiera o de seguridad.
4. Privacidad: ¿qué ocurre con lo que escribimos en una IA?
Este es uno de los riesgos que muchas personas pasan por alto.
Cuando utilizamos una IA en la nube, nuestros datos deben viajar hasta los servidores que ejecutan el servicio.
Dependiendo del proveedor y del producto utilizado, pueden existir diferentes políticas de almacenamiento, registro, revisión, utilización y eliminación de datos.
Por eso no conviene introducir alegremente:
- contraseñas;
- claves API;
- documentos empresariales confidenciales;
- información bancaria;
- datos personales de terceros;
- información médica privada;
- secretos comerciales;
- código propietario sin autorización.
Por ejemplo, la documentación de DeepSeek describe información técnica y de uso que puede recopilar el servicio y establece condiciones sobre el procesamiento de los datos.
Esto no significa que utilizar DeepSeek sea automáticamente peligroso.
Significa que antes de utilizar cualquier IA debemos conocer qué ocurre con nuestros datos.
¿Y si utilizamos una IA local?
Aquí aparece una de las grandes ventajas de los modelos de pesos abiertos (open-weights).
En lugar de enviar consultas a servidores remotos en la nube, podemos ejecutar estos modelos directamente en nuestro propio hardware.
La ejecución local puede reducir considerablemente la exposición de los datos, porque las consultas pueden procesarse directamente en nuestro propio hardware sin enviarlas a un proveedor externo.
Sin embargo, no es segura «por defecto». Para mantener un entorno protegido es necesario resguardar:
- el sistema operativo y la red local;
- las interfaces web (UI) e integraciones utilizadas;
- la procedencia de los modelos e inferencias descargados;
- los permisos de las aplicaciones que interactúan con el modelo.
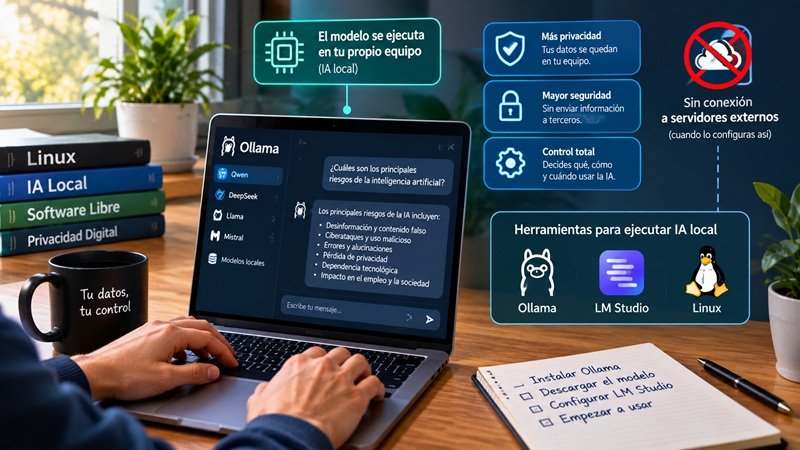
Para determinados datos confidenciales o sensibles, una solución local puede ofrecer un mayor grado de control, siempre que el sistema esté correctamente configurado y protegido.
Si quieres saber qué componentes de hardware necesitas para montarlo en tu propio equipo, revisa los requisitos para ejecutar IA local.
¿Puede la IA provocar una catástrofe?
Esta es probablemente la pregunta más difícil.
Existen investigadores y organizaciones que estudian escenarios en los que sistemas de IA mucho más capaces podrían causar daños graves.
Los escenarios analizados incluyen, entre otros:
- utilización de IA para ciberataques;
- asistencia para desarrollar armas;
- automatización de actividades peligrosas;
- sistemas autónomos con demasiado acceso a infraestructura;
- pérdida de control sobre sistemas altamente capaces;
- manipulación masiva de información;
- combinación de IA con otras tecnologías peligrosas.
No obstante, hay que hacer una distinción fundamental.
Que un escenario sea técnicamente posible no significa que vaya a ocurrir.
Tampoco sabemos con certeza cómo evolucionarán las capacidades futuras de los modelos.
Precisamente por esa incertidumbre, diferentes laboratorios están desarrollando sistemas de evaluación y políticas de seguridad.
Anthropic, por ejemplo, mantiene una política de escalamiento responsable que establece medidas de seguridad adicionales a medida que aumentan determinadas capacidades de sus modelos. Su marco contempla riesgos relacionados con ciberseguridad, armas químicas y biológicas, sabotaje, pérdida de control y manipulación.
Esto demuestra que los riesgos extremos no deben ignorarse, pero tampoco deben presentarse como una catástrofe inevitable.
¿Qué tendría que ocurrir para que la IA causara una catástrofe?
Un escenario verdaderamente grave probablemente no dependería únicamente de que un chatbot «se vuelva consciente».
Sería mucho más importante la combinación de varios factores.
Por ejemplo:
IA avanzada + autonomía + acceso a sistemas críticos + ausencia de controles + actores maliciosos
podría generar riesgos considerablemente mayores que un chatbot que simplemente responde preguntas.
La diferencia está en el nivel de acceso y autonomía.
Una IA que solamente escribe un texto tiene unas posibilidades de daño limitadas.
Una IA conectada a sistemas informáticos, cuentas financieras, servidores, armas o infraestructura crítica tiene un perfil de riesgo completamente diferente.
Por eso una de las medidas más importantes para prevenir escenarios graves consiste en aplicar el principio:
Cuanto mayor sea la capacidad y el acceso de una IA, mayores deben ser las medidas de seguridad y supervisión.
China vs. Estados Unidos: ¿por qué existe una carrera por la IA?
La competencia entre China y Estados Unidos es uno de los factores geopolíticos más importantes del desarrollo de la inteligencia artificial.
No se trata solamente de quién desarrolla el mejor chatbot.
La competencia incluye:
- procesadores;
- GPU;
- semiconductores;
- fabricación de chips;
- centros de datos;
- modelos de IA;
- talento tecnológico;
- infraestructura;
- propiedad intelectual;
- aplicaciones militares;
- ciberseguridad;
- cadenas de suministro.
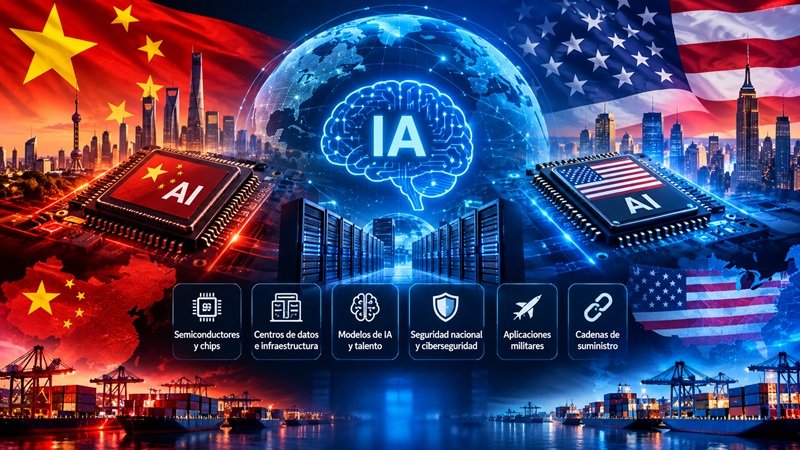
Estados Unidos y sus aliados han impuesto controles a determinadas tecnologías avanzadas relacionadas con semiconductores y equipos de fabricación. Un análisis del Center for Strategic and International Studies señala que esas restricciones comenzaron a partir de 2022 y han contribuido también a acelerar los esfuerzos chinos de autosuficiencia en semiconductores.
China ha desarrollado una industria muy activa de modelos de pesos abiertos, con familias como Qwen y DeepSeek compitiendo internacionalmente en diferentes tareas y segmentos del mercado.
Esta competencia tiene una consecuencia paradójica: cada potencia tiene incentivos para avanzar lo más rápido posible por temor a quedarse atrás. Esto genera una carrera tecnológica donde la velocidad de despliegue puede primar peligrosamente sobre los controles de seguridad y la evaluación de riesgos.
¿China y Estados Unidos pueden cooperar en seguridad de IA?
Aunque existe una fuerte competencia estratégica, la seguridad de la IA plantea problemas que no respetan fronteras.
Un ciberataque generado con IA, una campaña de desinformación o un sistema autónomo peligroso podrían afectar a otros países independientemente de dónde se haya desarrollado la tecnología.
Un análisis publicado por Carnegie Endowment en julio de 2026 plantea precisamente la posibilidad de mantener canales de diálogo entre Estados Unidos y China para reducir riesgos de seguridad de IA, incluso mientras continúa la competencia tecnológica.
Esto plantea una situación peculiar:
dos países pueden competir por desarrollar la tecnología y, al mismo tiempo, necesitar mecanismos para reducir los riesgos derivados de ella.
¿Las IA chinas gratuitas son mejores?
Esta pregunta aparece cada vez más en Internet.
La respuesta sencilla es:
No existe una IA que sea objetivamente la mejor para todos los usos.
Modelos como DeepSeek y Qwen han demostrado que existen alternativas chinas capaces de competir en diferentes tareas.
Qwen, por ejemplo, publicó Qwen3 con varios modelos de pesos abiertos y licencias Apache 2.0 para diferentes variantes, además de documentar su utilización local mediante herramientas como Ollama y LM Studio.
DeepSeek también mantiene una página oficial de transparencia con información sobre sus modelos publicados.
La comparación correcta debería considerar varias variables.
| Aspecto | Servicios SaaS propietarios (ChatGPT, Claude, etc.) | Modelos de pesos abiertos (Qwen, DeepSeek, Llama, Gemma) | IA en ejecución local (Ollama, LM Studio) |
|---|---|---|---|
| Coste | Suscripción o pago por uso de API | Generalmente gratuitos para descargar; algunas APIs pueden tener coste | Sin coste por consulta, pero requiere inversión en hardware |
| Privacidad | Los datos se procesan en servidores del proveedor y están sujetos a sus políticas | Depende de cómo se utilicen: en la nube están sujetos a las políticas del proveedor; localmente ofrecen mayor control | Mayor control sobre los datos, ya que las consultas pueden procesarse directamente en el equipo |
| Uso local | Normalmente no; el procesamiento principal se realiza en servidores del proveedor | Sí, si se descargan los pesos y se dispone del hardware y software necesarios | Sí, están diseñadas para facilitar la ejecución de modelos en equipos propios |
| Requisitos de hardware | Generalmente ninguno más allá de un dispositivo con conexión a Internet | Dependen del tamaño del modelo si se ejecutan localmente | Dependen del modelo, la RAM, la CPU, la GPU y el almacenamiento disponibles |
| Control sobre los datos | Limitado por las políticas, infraestructura y configuración del proveedor | Mayor si los modelos se ejecutan localmente | Alto, siempre que el sistema, las aplicaciones y las conexiones externas estén correctamente configurados |
| Dependencia de Internet | Generalmente necesaria | Depende de si se utiliza en la nube o localmente | Puede funcionar sin conexión para tareas que no requieran servicios externos |
| Configuración | Baja: normalmente basta con registrarse y utilizar el servicio | Media o alta cuando se ejecutan localmente | Media: requiere instalar el software, descargar modelos y configurar el entorno |
| Independencia del proveedor | Baja: depende de la plataforma y sus servicios | Mayor cuando los pesos pueden descargarse y ejecutarse localmente | Alta, aunque sigue dependiendo del hardware, software y modelo utilizado |
Por lo tanto, «gratis» no significa necesariamente «mejor», y «china» tampoco significa automáticamente «insegura» en todos los contextos.
La clave está en distinguir dónde se procesan los datos:
- En la nube (SaaS): Usar las plataformas web o APIs de proveedores externos (sean chinos u occidentales) implica someterse a sus políticas de privacidad y a las condiciones legales aplicables al servicio y al lugar donde se procesan los datos.
- En local: La ejecución local puede ofrecer un mayor control sobre los datos porque las consultas pueden procesarse directamente en nuestro propio equipo, sin necesidad de enviarlas al proveedor del modelo. Sin embargo, esto depende de la configuración del entorno: las aplicaciones, interfaces, plugins o integraciones utilizadas podrían establecer conexiones externas.
- Para trabajar con información especialmente sensible: no basta con instalar un modelo local. También es necesario revisar las conexiones de red, los permisos de las aplicaciones y las herramientas que interactúan con el modelo.
Por eso, antes de elegir una herramienta es fundamental analizar:
- qué modelo estamos utilizando;
- dónde se ejecuta (servidor en la nube o hardware local);
- qué datos enviamos y qué normativa legal los ampara;
- qué política de privacidad y retención tiene el servicio;
- qué permisos y accesos posee el sistema;
- qué capacidades reales necesitamos para la tarea.
DeepSeek, Qwen, ChatGPT o IA local: ¿cuál utilizar?
En lugar de buscar una única ganadora, conviene elegir según el uso.
Para uso general
Una IA comercial como ChatGPT, Gemini o Claude puede ser conveniente cuando se busca facilidad de uso, herramientas integradas y acceso a modelos avanzados sin configurar hardware.
Para experimentar con modelos chinos
DeepSeek y Qwen son alternativas interesantes para comparar resultados y capacidades.
Sin embargo, debemos revisar siempre las condiciones del servicio antes de introducir información sensible.
Para privacidad y control
La IA local es especialmente interesante.
Puedes ejecutar modelos compatibles directamente en Linux o Windows utilizando herramientas como Ollama o LM Studio.
Para desarrolladores
Los modelos locales permiten experimentar sin depender necesariamente de una API externa para cada consulta.
Esto puede resultar especialmente atractivo cuando se trabaja con código, documentación privada o proyectos de desarrollo.
¿Cómo utilizar la inteligencia artificial de forma responsable?
Utilizar IA responsablemente no significa dejar de utilizarla.
Significa mantener al ser humano como responsable de las decisiones importantes.
Estas son algunas reglas sencillas.
1. No introduzcas información confidencial sin necesidad
Antes de pegar un documento en una IA pregúntate:
¿Me sentiría cómodo si este contenido terminara almacenado en un servidor externo?
Si la respuesta es no, considera anonimizarlo o utilizar una solución local.
2. Verifica la información importante
No aceptes automáticamente una respuesta porque esté bien redactada.
Comprueba:
- cifras;
- fuentes;
- fechas;
- nombres;
- comandos;
- legislación;
- información financiera;
- información médica;
- afirmaciones técnicas.
3. No delegues completamente decisiones críticas
La IA puede ayudarte a analizar información.
La decisión final debería permanecer bajo control humano cuando las consecuencias sean importantes.
4. Limita los permisos de los agentes
Una IA con acceso a tus archivos, correo electrónico, navegador o cuentas puede hacer mucho más que un chatbot convencional.
Por eso conviene utilizar el principio de mínimo privilegio.
Si una herramienta solamente necesita leer un archivo, no debería tener acceso completo a todo el ordenador.
5. Mantén copias de seguridad
Especialmente cuando experimentes con agentes de IA que puedan modificar archivos o ejecutar comandos.
6. Utiliza autenticación multifactor
La IA no reemplaza las medidas básicas de ciberseguridad.
Contraseñas únicas, gestores de contraseñas, actualizaciones y MFA siguen siendo fundamentales.
7. Aprende cómo funciona la herramienta
No necesitas convertirte en investigador de IA.
Pero sí deberías conocer:
- quién desarrolla el modelo;
- dónde se ejecuta;
- qué datos procesa;
- qué permisos tiene;
- cuáles son sus limitaciones.
¿Cómo podemos evitar una catástrofe causada por la IA?
No existe una medida única que pueda garantizar que nunca ocurrirá un accidente grave.
La prevención requiere varias capas.
Investigación de seguridad
Los modelos deben someterse a pruebas antes y después de su lanzamiento.
Evaluaciones independientes
No debería depender exclusivamente del fabricante determinar si su propio modelo es seguro.
Límites de acceso
Una IA extremadamente capaz no debería tener automáticamente acceso ilimitado a sistemas críticos.
Supervisión humana
Las operaciones de alto impacto deberían incorporar mecanismos para detener o revisar acciones.
Ciberseguridad
Los propios modelos y sus infraestructuras deben protegerse frente al robo, manipulación y uso malicioso.
Transparencia
Los usuarios y organismos reguladores necesitan conocer los riesgos relevantes de los sistemas desplegados.
Cooperación internacional
Los riesgos que atraviesan fronteras requieren mecanismos de comunicación y coordinación.
NIST plantea precisamente la gestión del riesgo como un proceso continuo que debe incorporarse al diseño, desarrollo, uso y evaluación de sistemas de IA.
El papel del software libre y la IA local
Aquí aparece una cuestión fundamental para la soberanía tecnológica y el ecosistema del software libre.
Una parte central del debate gira en torno a quién controla los modelos, la infraestructura, los datos y las plataformas. Aunque muchos de estos modelos no cumplen con la definición estricta de software libre debido a sus licencias de uso, la disponibilidad de modelos de pesos abiertos permite a desarrolladores e investigadores descargar determinados componentes del modelo, ejecutarlos localmente y, según su licencia, adaptarlos e integrarlos en sus propios sistemas.
Familias de modelos como Qwen o Llama, junto a herramientas de código abierto como Ollama, llama.cpp o vLLM, permiten desplegar sistemas avanzados de forma privada. Para la comunidad y los usuarios de sistemas como Linux, esto representa una oportunidad para acceder a capacidades avanzadas de inteligencia artificial manteniendo un mayor control sobre los datos y reduciendo la dependencia de la infraestructura de terceros. Si quieres conocer los componentes para montarlo en tu propio equipo, puedes consultar nuestra guía sobre hardware para IA local.
La IA no es el enemigo: la falta de control puede serlo
La discusión sobre los riesgos de la inteligencia artificial suele caer en dos extremos.
Uno afirma que la IA solucionará prácticamente todos nuestros problemas.
El otro sostiene que inevitablemente destruirá nuestra sociedad.
Probablemente ninguno de los dos extremos describe adecuadamente la situación actual.
La inteligencia artificial es una tecnología extremadamente poderosa.
Puede utilizarse para:
- mejorar la productividad;
- aprender;
- programar;
- investigar;
- automatizar tareas;
- desarrollar software;
- analizar información;
- mejorar determinados procesos científicos y empresariales.
Pero esas mismas capacidades pueden utilizarse para cometer fraude, automatizar ataques, producir desinformación o amplificar errores humanos.
La tecnología no elimina la responsabilidad humana.
La aumenta.
¿Qué podemos hacer desde hoy?
No necesitamos esperar a que los gobiernos, las grandes empresas tecnológicas o los investigadores solucionen todos los problemas.
Como usuarios podemos adoptar algunas medidas inmediatamente:
1. Elegir conscientemente qué IA utilizamos.
2. No entregar información confidencial innecesariamente.
3. Verificar las respuestas importantes.
4. Mantener nuestros dispositivos actualizados.
5. Utilizar MFA y contraseñas seguras.
6. Limitar los permisos de los agentes de IA.
7. Considerar IA local para información especialmente sensible.
8. Aprender a reconocer deepfakes y desinformación.
9. No asumir que una IA es segura simplemente porque es gratuita.
10. Mantener siempre una persona responsable de las decisiones importantes.
Conclusión: el verdadero desafío será aprender a controlar una tecnología cada vez más poderosa
Los riesgos de la inteligencia artificial son reales, pero no todos tienen la misma probabilidad ni la misma gravedad.
Los problemas más inmediatos incluyen la desinformación, el fraude, la privacidad, los errores y el uso de IA para aumentar determinadas capacidades ofensivas.
A más largo plazo existen escenarios mucho más graves relacionados con sistemas autónomos, ciberseguridad, armas, pérdida de control y otras capacidades que todavía son objeto de investigación.
Por eso no tiene sentido ignorar los riesgos.
Pero tampoco tiene sentido afirmar que una catástrofe es inevitable.
La estrategia más razonable consiste en desarrollar la IA mientras aumentan proporcionalmente las medidas de seguridad, evaluación, supervisión y control.
Y para los usuarios existe además una decisión importante: no depender necesariamente de una única empresa o plataforma.
La combinación de software libre, modelos abiertos, Linux e IA local puede proporcionar un mayor grado de control sobre nuestros datos y nuestra infraestructura.
La pregunta ya no debería ser solamente:
¿Qué puede hacer la inteligencia artificial?
También deberíamos preguntarnos:
¿Quién la controla, qué datos utiliza, qué permisos tiene y qué ocurriría si algo sale mal?
Cuanto antes aprendamos a hacernos esas preguntas, mejor preparados estaremos para aprovechar la inteligencia artificial sin renunciar innecesariamente a nuestra privacidad, seguridad y autonomía tecnológica.