Elegir el mejor VPS para Ollama marca la diferencia entre un asistente de IA lento y uno que responde en segundos. Ejecutar modelos de lenguaje en local tiene ventajas claras: privacidad total, sin costes por token y control absoluto sobre tus datos. Pero tu PC tiene límites: se calienta, consume luz y no está encendido 24/7.
Un VPS cambia eso. Con Ollama en un servidor remoto puedes tener tu asistente de IA disponible siempre, acceder desde cualquier dispositivo y escalar los recursos según los modelos que quieras ejecutar.
La pregunta no es «¿debería usar un VPS?», sino «¿cuál necesito realmente?». Y la respuesta depende del tamaño del modelo que vayas a ejecutar.
¿Qué necesita un VPS para ejecutar Ollama?
Antes de elegir, necesitas entender tres conceptos básicos:
La RAM es el límite principal. Ollama carga el modelo completo en memoria. La regla práctica es aproximadamente 1 GB de RAM por cada mil millones de parámetros en cuantización Q4 (el formato por defecto de Ollama).
La CPU afecta la velocidad. No todos los procesadores sirven. Los AMD EPYC y los Intel con soporte AVX2 son los que mejor rinden para inferencia en CPU. Un modelo de 7B puede generar entre 10 y 15 tokens por segundo en una CPU decente.
La GPU acelera todo, pero dispara el precio. Una GPU puede multiplicar por 10 o 50 la velocidad, pero los VPS con GPU cuestan desde 90 euros al mes, comparado con 15 euros de un VPS con CPU potente.
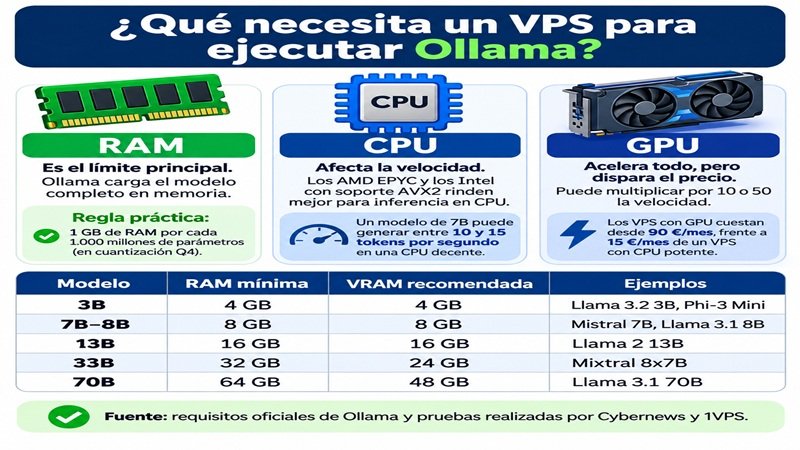
Tabla de requisitos según el modelo
| Modelo | RAM mínima (CPU) | VRAM recomendada (GPU) | Ejemplos |
|---|---|---|---|
| 3B | 4 GB | 4 GB | Llama 3.2 3B, Phi-3 Mini |
| 7B–8B | 8 GB | 8 GB | Mistral 7B, Llama 3.1 8B |
| 13B | 16 GB | 16 GB | Llama 2 13B |
| 33B | 32 GB | 24 GB | Mixtral 8x7B |
| 70B | 64 GB | 48 GB | Llama 3.1 70B |
Fuente: requisitos oficiales de Ollama y pruebas realizadas por Cybernews y 1VPS
Comparativa: los mejores VPS para Ollama en 2026
He seleccionado los proveedores que realmente funcionan para Ollama, con precios verificados y planes concretos que puedes contratar hoy.
1. Hetzner CPX41 — Mejor relación calidad-precio en CPU
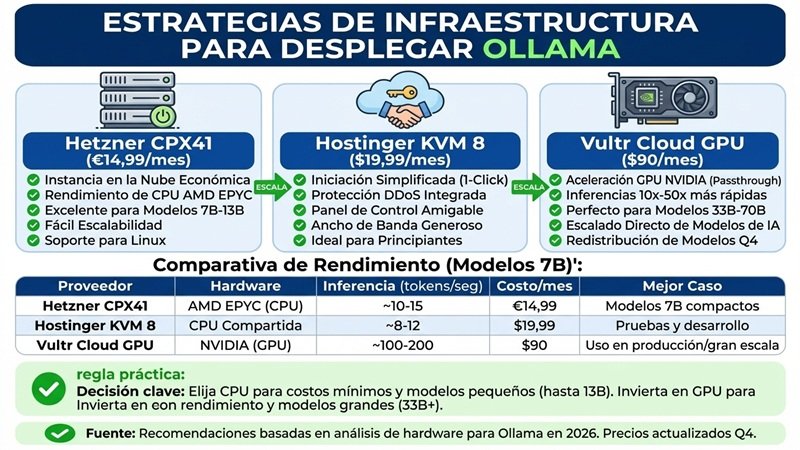
Precio: €14,99/mes | 8 vCPU AMD EPYC, 16 GB RAM, 160 GB NVMe
Hetzner es el rey indiscutible del precio-rendimiento en Europa. Sus CPUs AMD EPYC tienen un rendimiento AVX2 excelente para inferencia, y con 16 GB de RAM puedes ejecutar modelos de 13B sin problema.
Rendimiento real: aproximadamente 10–15 tokens/segundo con Llama 3.2 8B en cuantización Q4_K_M.
Ventajas:
- Precio imbatible en su rango
- Infraestructura alemana con cumplimiento GDPR
- Tráfico generoso en Europa
- Root access completo para configurar todo a tu manera
Desventajas:
- Sin instalación guiada de Ollama (todo manual)
- Los backups y snapshots cuestan extra
- No está pensado para principiantes
Ideal para: usuarios técnicos que quieren máximo rendimiento por euro invertido.
2. Hostinger KVM 8 — La opción más fácil para empezar
Precio: $19,99/mes | 8 vCPU, 16 GB RAM, 200 GB NVMe
Hostinger combina buenas especificaciones con una de las cosas que Hetzner no ofrece: panel hPanel que facilita la gestión y opciones de despliegue más sencillas. Si estás empezando con servidores Linux, Hostinger te ahorra horas de frustración.
Ventajas:
- Panel de control intuitivo
- Instalación de Ollama más sencilla
- 200 GB de almacenamiento para múltiples modelos
- Garantía de devolución de 30 días
- Backups semanales incluidos
Desventajas:
- Sin opciones de GPU
- Ligeramente más caro que Hetzner por especificaciones similares
- Menos centros de datos que Hetzner
Ideal para: quien quiere empezar sin pelearse con la configuración del servidor.
3. Vultr High Frequency — El más rápido en CPU
Precio: $48/mes | 4 vCPU a 3GHz+, 16 GB RAM, 256 GB NVMe
Vultr apuesta por velocidades de reloj más altas en lugar de más núcleos. Para inferencia en CPU, esto marca una diferencia real: un solo hilo más rápido significa respuestas más ágiles.
Ventajas:
- CPUs con frecuencias más altas (mejor latencia)
- Infraestructura global con 32 ubicaciones
- Opción de escalar a GPU sin cambiar de proveedor
- Ideal si la velocidad de respuesta es crítica
Desventajas:
- Más caro que Hetzner para especificaciones similares
- Menos amigable para principiantes
- El plan de entrada ($2,50/mes) no sirve para Ollama serio
Ideal para: quien necesita respuestas rápidas y no le importa pagar más.
4. DigitalOcean — Para desarrolladores que quieren control
Precio: $48/mes | Droplet con 8 GB RAM y 160 GB almacenamiento
DigitalOcean ofrece algo único: una aplicación de marketplace con Ollama y Open WebUI preconfigurada. En 15–20 minutos tienes una interfaz web funcional sin tocar la terminal.
Ventajas:
- Despliegue con un clic desde el marketplace
- Control total vía SSH si lo necesitas
- Posibilidad de escalar a Droplets con GPU
- Snapshots para revertir cambios
Desventajas:
- Más caro que las alternativas europeas
- Sin garantía de devolución
- El plan básico de $4 no es suficiente para uso real
Ideal para: desarrolladores que quieren la comodidad de una instalación guiada sin perder control.
5. Vultr Cloud GPU — La opción más accesible con GPU
Precio: $90/mes | NVIDIA A16 (16 GB VRAM), 6 vCPU, 16 GB RAM
Si necesitas la velocidad de una GPU pero tu presupuesto no llega a las opciones de gama alta, Vultr ofrece la instancia GPU más accesible del mercado. Con 16 GB de VRAM puedes ejecutar modelos de hasta 30B parámetros.
Rendimiento real: 50–80 tokens/segundo con Llama 3.2 8B. Comparado con los 10–15 tokens de una CPU, la diferencia es enorme.
Ventajas:
- GPU accesible (el plan más barato del mercado)
- 16 GB de VRAM para modelos medianos
- Escalable a GPU más potentes
- Facturación por horas si no la necesitas 24/7
Desventajas:
- 90 euros al mes es una inversión seria
- El plan de CPU sigue siendo necesario para tareas ligeras
- No incluye garantía de devolución
Ideal para: quien necesita velocidad real y puede permitirse la inversión.
Tabla comparativa rápida
| Proveedor | Precio/mes | RAM | CPU | Almacenamiento | GPU | Ideal para |
|---|---|---|---|---|---|---|
| Hetzner CPX41 | €14,99 | 16 GB | 8 vCPU EPYC | 160 GB NVMe | No | Mejor precio/rendimiento |
| Hostinger KVM 8 | $19,99 | 16 GB | 8 vCPU | 200 GB NVMe | No | Principiantes |
| Vultr HF | $48 | 16 GB | 4 vCPU 3GHz+ | 256 GB NVMe | Opcional | Máxima velocidad CPU |
| DigitalOcean | $48 | 8 GB | 4 vCPU | 160 GB | Opcional | Instalación fácil |
| Vultr GPU | $90 | 16 GB | 6 vCPU | 320 GB | A16 16GB | Velocidad GPU |
CPU vs GPU: cuál elegir para Ollama
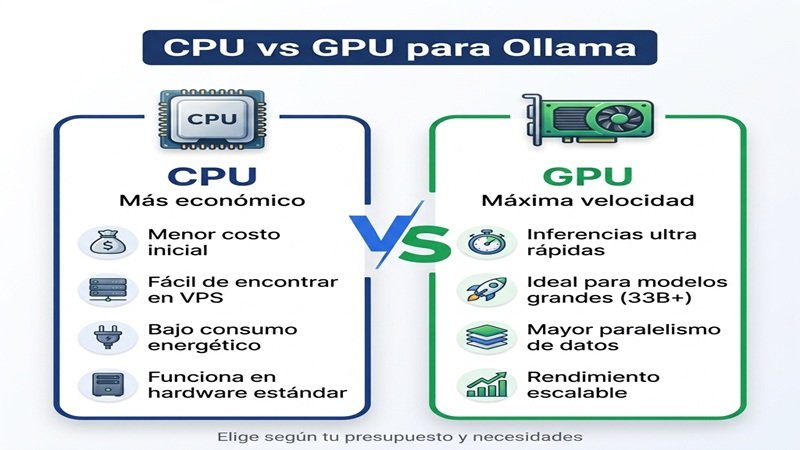
La decisión entre CPU y GPU es la más importante al elegir un VPS para Ollama. No hay una respuesta universal: depende de tu uso y tu presupuesto.
Cuándo elegir CPU
- Presupuesto ajustado (€15–50/mes)
- Uso personal o pruebas
- Modelos de 7B a 13B
- No necesitas respuestas ultrarrápidas
- VPS sin GPU dedicada
Ventajas: más barato, disponible en cualquier proveedor, no requiere configuración especial.
Desventajas: velocidad limitada (10–15 tokens/segundo para 7B), no sirve para modelos grandes.
Cuándo elegir GPU
- Presupuesto amplio (€90+/mes)
- Uso intensivo o de producción
- Modelos de 13B a 70B
- Necesitas velocidad real (50+ tokens/segundo)
- Procesamiento de documentos largos o generación de código
Ventajas: velocidad 10–50x superior, permite modelos grandes, mejor experiencia de usuario.
Desventajas: precio alto, disponibilidad limitada, requiere configuración adicional.
La regla práctica
Si vas a usar Ollama para aprender o como asistente personal, empieza con CPU. Si tu proyecto crece y necesitas velocidad, migra a GPU. No empieces pagando 90 euros al mes si no lo necesitas.
¿Cuál elegir según tu caso?
Cada perfil necesita un VPS distinto. Estos son los cinco escenarios más comunes y la opción que mejor encaja en cada uno.
Presupuesto ajustado y perfil técnico → Hetzner CPX41
Si sabes usar SSH y no te asusta configurar todo desde cero, Hetzner te da más RAM y CPU por menos dinero que cualquier otro. 15 euros al mes para ejecutar modelos de 13B con fluidez es difícil de superar.
Quieres empezar sin complicaciones → Hostinger KVM 8
El panel de Hostinger y la posibilidad de desplegar Ollama con un clic (o casi) te ahorran las primeras horas de frustración. Por 20 dólares al mes tienes un servidor listo para usar en menos de una hora.
Necesitas velocidad de respuesta → Vultr High Frequency
Los 3GHz+ de Vultr se notan cuando pides respuestas rápidas. Si estás construyendo un asistente que debe responder en segundos, la diferencia entre 10 y 15 tokens/segundo se siente.
Quieres GPU sin arruinarte → Vultr Cloud GPU
Los 90 euros al mes duelen, pero es el precio más bajo del mercado para tener una GPU real. Si vas a usar Ollama de forma intensiva (generación de código, procesamiento de documentos largos), la inversión se justifica.
Estás desarrollando un agente de IA → DigitalOcean
Si Ollama forma parte de un sistema mayor (agentes, automatizaciones, bases de datos vectoriales), DigitalOcean ofrece el equilibrio entre facilidad y control que necesitas. La integración con Open WebUI desde el marketplace es un plus.
Cómo instalar Ollama en tu VPS paso a paso
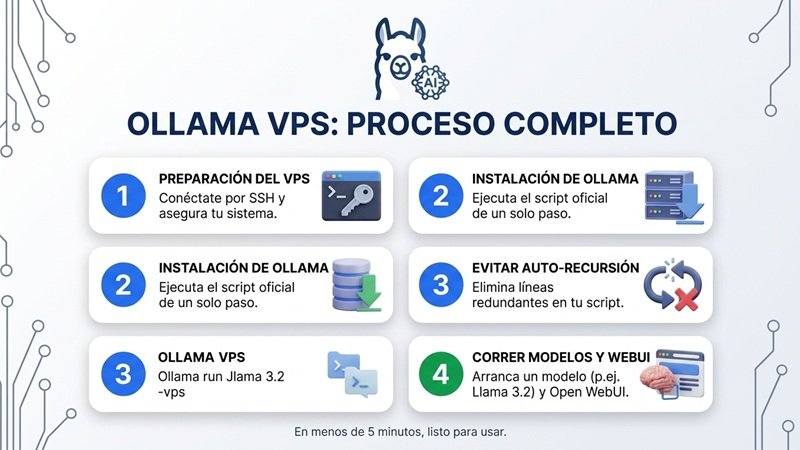
Una vez contratado tu VPS, el proceso es prácticamente idéntico en todos los proveedores:
Paso 1: Conéctate por SSH desde tu terminal:
ssh root@tu-ip-del-vpsPaso 2: Ejecuta el script oficial de instalación:
curl -fsSL https://ollama.ai/install.sh | shPaso 3: Descarga y ejecuta un modelo:
ollama run llama3.2En menos de 5 minutos tienes Ollama funcionando. Si quieres una interfaz web para gestionarlo, instala Open WebUI:
docker run -d -p 3000:8080 -v ollama:/root/.ollama -v open-webui:/app/backend/data --name open-webui --restart always ghcr.io/open-webui/open-webui:mainPuedes consultar la documentación oficial de Ollama para ver todos los modelos disponibles.
Si tienes dudas con el proceso, tienes una guía completa paso a paso aquí: Instalar Ollama en Ubuntu.
Errores comunes al elegir un VPS para Ollama
Error 1: contratar el plan más barato. Un VPS de 4 GB de RAM por 5 dólares no sirve para nada más que pruebas. Los modelos de 7B necesitan 8 GB, y los de 13B, 16 GB. No escatimes en RAM.
Error 2: ignorar la CPU. No todos los procesadores sirven para inferencia. Asegúrate de que el VPS tenga CPU con soporte AVX2 y, idealmente, una frecuencia alta. Los AMD EPYC de Hetzner son una apuesta segura.
Error 3: pensar que necesitas GPU sí o sí. Para uso personal (un asistente, pruebas, aprendizaje), una CPU potente es suficiente. La GPU tiene sentido cuando necesitas velocidad de producción o modelos grandes.
Error 4: olvidar el almacenamiento. Cada modelo pesa entre 4 y 40 GB. Necesitas espacio para varios modelos, logs y el sistema operativo. 160 GB es un buen punto de partida.
Preguntas frecuentes sobre Ollama en VPS
¿Cuánta RAM necesita un VPS para Ollama?
Para modelos de 7B necesitas 8 GB. Para 13B, 16 GB. Para 33B, 32 GB. Para 70B, 64 GB. La regla es aproximadamente 1 GB de RAM por cada mil millones de parámetros en cuantización Q4.
¿Puedo ejecutar Ollama sin GPU?
Sí. Ollama funciona perfectamente solo con CPU. La velocidad será menor (10–15 tokens/segundo para 7B), pero es suficiente para uso personal y pruebas.
¿Cuánto cuesta un VPS para IA?
Desde 15 euros al mes (Hetzner CPX41) para CPU, hasta 90 euros al mes para una GPU accesible (Vultr A16). El precio depende del modelo que quieras ejecutar y si necesitas GPU.
¿Qué VPS es más barato para Ollama?
Hetzner CPX41 a 14,99 euros al mes es la opción más económica que realmente funciona para uso serio. Los planes de 4–5 dólares no sirven más que para pruebas.
¿Ollama funciona en cualquier VPS?
Sí, siempre que tenga suficiente RAM y una CPU con soporte AVX2. Cualquier VPS Linux (Ubuntu, Debian, etc.) puede ejecutar Ollama.
Conclusión: cuál elegir
Si tuviera que recomendar una sola opción, sería Hetzner CPX41. Por 15 euros al mes tienes un servidor con 16 GB de RAM y un procesador EPYC que ejecuta modelos de 13B con fluidez. Es la combinación perfecta de precio, rendimiento y fiabilidad.
Si prefieres pagar un poco más por comodidad, Hostinger KVM 8 te da lo mismo con mejor soporte y panel de control.
Y si tu proyecto requiere velocidad real, Vultr Cloud GPU es la puerta de entrada más accesible al mundo de la inferencia acelerada.
La decisión final depende de tu presupuesto y de los modelos que quieras ejecutar. Pero con cualquiera de estas opciones, tendrás un asistente de IA disponible 24/7, sin depender de servicios externos ni pagar por token.
Artículos relacionados
- Requisitos para ejecutar IA local: qué PC necesitas según el modelo
- Hardware para IA local en 2026: guía completa
- Ollama vs LM Studio: cuál elegir
- Los mejores VPS Linux baratos